Loop
Le node Loop répète une séquence de nodes pour chaque élément d'une liste en entrée, permettant le traitement en lot sur des tableaux.
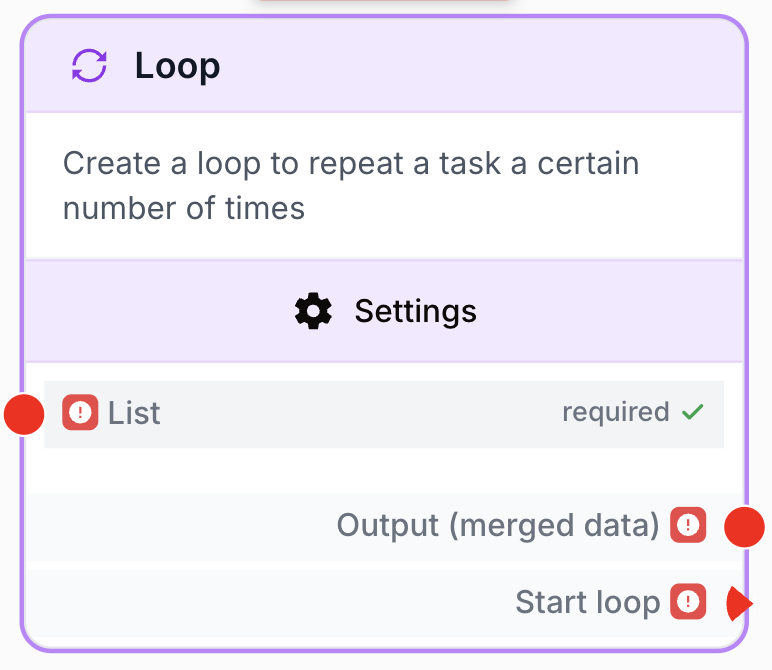
À quoi sert le node Loop ?
Le node Loop (libellé : Loop Node) parcourt une liste et exécute une branche dédiée une fois par élément. C’est un node de contrôle de flux : connectez une liste à l’entrée List, construisez la branche par itération depuis Start loop, fermez-la sur End Loop, puis récupérez les résultats agrégés sur Output (merged data) une fois toutes les itérations terminées.
Cas d’usage typiques :
- Scraper une liste d’URL provenant de Google Sheets, d’une API ou d’une liste manuelle.
- Parcourir des lignes de feuille de calcul pour les enrichir, les transformer ou les envoyer une à une.
- Appliquer un prompt LLM à chaque entrée d’un tableau (titres, descriptions, produits).
- Démultiplier un appel d’intégration (HubSpot, BigQuery, WordPress) sur un lot d’enregistrements.
Configuration rapide
Suivez ces étapes pour ajouter et configurer le node Loop dans votre workflow :
Ajouter le node au canevas
Ouvrez la bibliothèque de nodes (Node Library), naviguez dans Tools > Flow Control, puis glissez-déposez le node Loop Node sur votre espace de travail.
Connecter la liste en entrée
Reliez la sortie du node amont (Google Sheets, API Connector, Create List, Split List, etc.) au port d’entrée List. La valeur doit être un tableau JSON.
Construire la branche par itération
Reliez la sortie Start loop au premier node qui doit s’exécuter pour chaque élément (par exemple Web Scraper ou LLM). Lorsque vous tracez la connexion, nommez la variable qui contiendra l’élément courant (par exemple item ou ligne).
Fermer la branche sur End Loop
Reliez le dernier node de la branche interne au point de connexion End Loop (créé automatiquement à côté du node Loop). Sans cette connexion, la boucle ne peut pas se terminer et le workflow affichera une erreur de validation.
Paramétrer les limites et la gestion d’erreur
Ouvrez les paramètres du node pour définir Max Iterations (1–100), Delay between iterations (≥ 100 ms) et Error Handling (Skip & Continue ou None).
Exploiter la sortie agrégée
Reliez le port Output (merged data) à un node en dehors de la boucle (Filter List, JSON Path Extractor, Sheets Writer, etc.) pour consommer le tableau de résultats agrégés depuis chaque itération.
Paramètres de configuration
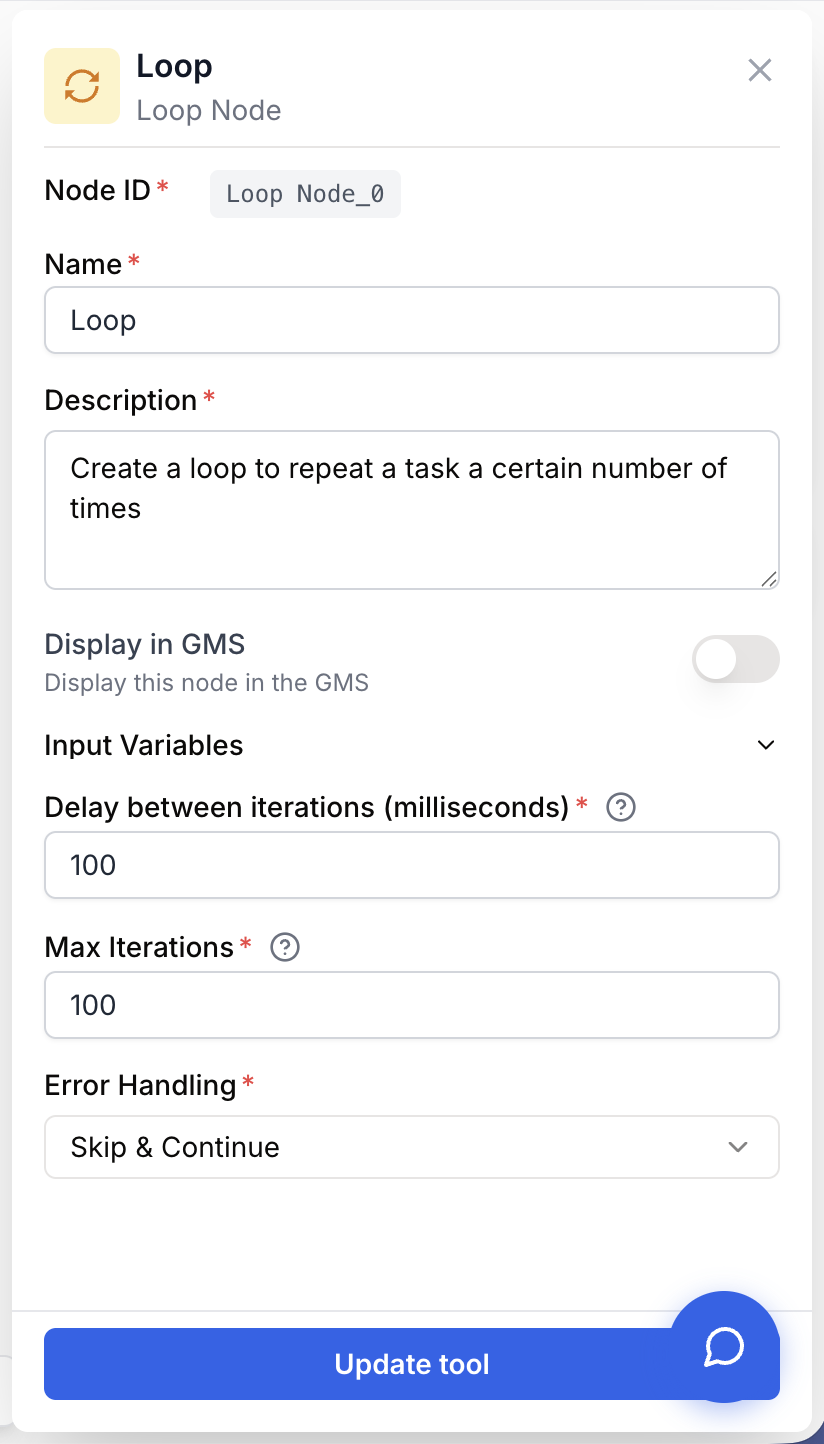
Le node Loop dispose d’une liste d’entrée, de trois paramètres de configuration et de deux sorties. Les réglages sont validés par le formulaire : les valeurs invalides sont refusées avant l’enregistrement.
Champs requis
Name string required default: Loop Nom du node — Identifie le node sur le canevas. Renommez-le (ex. LoopOverUrls) avant de construire la branche interne pour garder un workflow lisible.
Description string required default: Create a loop to repeat a task a certain number of times. Description du node — Phrase courte décrivant ce sur quoi la boucle itère. Utile pour la documentation et le débogage.
List json required Liste en entrée — Tableau JSON des éléments à parcourir. Provenant d’une sortie d’un node amont ({{GoogleSheets_0.data}}, {{ApiConnector_0.body.results}}) ou d’une liste statique (["a", "b", "c"]). Le runner lève « Loop node does not have a valid input list » si la valeur ne peut pas être parsée comme JSON.
Champs optionnels
Delay between iterations (milliseconds) number default: 100 Délai inter-itérations — Pause insérée entre deux itérations consécutives, en millisecondes. Minimum : 100 ms. Augmentez-le (1000–3000 ms) lorsque la branche interne sollicite des API externes pour éviter le rate limiting.
Max Iterations number default: 100 Nombre maximum d’itérations — Plafond strict du nombre d’itérations exécutées. Plage : 1 à 100. Si la liste d’entrée dépasse cette valeur, seuls les N premiers éléments sont traités.
Error Handling string default: Skip Stratégie de gestion d’erreur — Comportement de la boucle face à un échec dans une itération.
Skip— Skip & Continue : l’itération en échec est ignorée, la boucle passe à l’élément suivant. Par défaut.None— La boucle s’arrête à la première erreur et l’ensemble du workflow échoue.
Conservez Skip & Continue pour les traitements en lot où un succès partiel est acceptable (scraping, enrichissement). Passez à None lorsque chaque élément est critique (écritures financières, e-mails transactionnels) afin qu’un échec remonte immédiatement.
Que renvoie le node ?
Le node Loop expose trois points de connexion sur le canevas. Chacun a un rôle distinct :
| Port | Rôle en une phrase |
|---|---|
| Start loop | Démarre la branche interne avec l’élément courant de la liste |
| End Loop | Ferme la branche interne et indique quelle sortie est collectée pour cette itération |
| Output (merged data) | Renvoie le tableau agrégé une fois toutes les itérations terminées |
graph LR
    List[List amont] --> Loop[Loop Node]
    Loop -->|Start loop| Inner[Branche interne]
    Inner --> EndLoop[End Loop]
    Loop -->|Output merged data| After[Nodes aval]
Start loop json Déclencheur par itération. Branchez ici le premier node de votre branche interne. À chaque itération, Draft & Goal transmet un seul élément de la liste d’entrée via cette connexion — la ligne courante, l’URL, le contact, etc. Vous choisissez le nom de la variable lorsque vous tracez le lien (par exemple item).
End Loop json Point de fermeture de la branche interne (handle violet à droite du groupe Loop, créé automatiquement). Reliez-y le dernier node utile de la chaîne — ou chaque extrémité d’un branchement Conditional. Ce port ne produit pas de données utilisables en aval : il indique au moteur d’exécution quelle sortie de node récupérer pour alimenter Output (merged data) à la fin de l’itération.
Output (merged data) json Tableau JSON agrégé, disponible une fois la boucle terminée. Chaque entrée du tableau est la sortie collectée via End Loop pour une itération réussie, dans l’ordre de la liste d’entrée. Ce port est le seul moyen de consommer les résultats du lot en aval de la boucle.
Le port End Loop en détail
À quoi sert End Loop ?
End Loop n’est pas une sortie de données comme Output (merged data). C’est une borne de fin de branche :
- Elle ferme le sous-workflow exécuté à chaque itération (connexion obligatoire — sans elle, le workflow affiche Missing End Loop connection).
- Elle désigne le node dont la sortie sera enregistrée pour l’itération en cours.
- Elle ne transmet rien aux nodes placés après le Loop — utilisez Output (merged data) pour cela.
Combien de connexions vers End Loop ?
- Chaîne simple (Start loop → A → B → C → End Loop) : une seule connexion entrante sur End Loop — depuis le dernier node de la chaîne.
- Branchement Conditional : chaque branche peut être reliée à End Loop (branche « vraie » avec traitement + branche « fausse » / par défaut pour ignorer l’élément). Le canevas autorise plusieurs fils entrants sur End Loop lorsqu’ils proviennent de branches conditionnelles.
- Plusieurs chaînes parallèles non conditionnelles toutes câblées sur End Loop : à éviter — le canevas peut bloquer ces connexions, et le moteur ne fusionne pas automatiquement plusieurs sorties.
Quelles données sont agrégées ?
À chaque itération, le moteur d’exécution :
- Exécute la branche interne déclenchée par Start loop.
- Repère les nodes reliés à End Loop.
- Prend la sortie (
output) du premier node terminal valide (état terminé, sortie non vide). - Ajoute cette valeur au tableau Output (merged data).
Ce qui est collecté :
- Uniquement la sortie du node connecté à End Loop pour l’itération (texte, objet JSON, nombre, etc. — selon ce que ce node produit).
Ce qui n’est pas collecté automatiquement :
- L’élément d’entrée de l’itération (
item,ligne, etc.) — sauf si vous l’incluez vous-même dans la sortie du dernier node (par exemple via un Code Block). - Les sorties intermédiaires des autres nodes de la branche — seul le terminal relié à End Loop compte.
- L’ensemble des variables définies dans la branche.
Format de chaque entrée du merged data
Output (merged data) est toujours un tableau JSON. Chaque position correspond à une itération dont la branche s’est terminée avec une sortie valide :
[
  "résultat itération 1",
  { "title": "Article A", "score": 85 },
  { "title": "Article B", "score": 72 }
]| Situation | Effet sur le tableau agrégé |
|---|---|
| Itération réussie, node terminal avec sortie | Une entrée ajoutée (texte, objet ou valeur produite par le node) |
| Itération réussie mais aucune sortie valide au terminal | Une entrée null peut être ajoutée |
Itération en erreur avec Error Handling = Skip | Aucune entrée ajoutée — le tableau peut être plus court que la liste d’entrée |
Itération en erreur avec Error Handling = None | Le workflow entier échoue |
L’élément d’entrée original n’est pas fusionné automatiquement dans chaque entrée du tableau. Pour conserver à la fois l’entrée et le résultat, regroupez-les dans un Code Block ou structurez la sortie du dernier node en objet JSON :
{ "input": { "email": "alice@example.com" }, "result": "…" }Limites de la boucle — ce que vous pouvez (et ne pouvez pas) câbler
La branche interne (tout ce qui se trouve entre Start loop et End Loop) forme une zone fermée sur le canevas.
Autorisé :
- Start loop → premier node de la branche interne (un élément par itération).
- Nodes à l’intérieur de la branche reliés les uns aux autres en séquence (par exemple Web Scraper → HTML Cleaner → LLM).
- Dernier node interne → End Loop (obligatoire).
- Entrée List du node Loop ← tout node amont qui produit le tableau complet (Google Sheets, Create List, API Connector, etc.).
- Nodes Input (Text Input, Url, File, etc.) et nodes Static_ (Static Text, Static File, etc.) câblés dans la branche interne — seuls types de nodes extérieurs autorisés à alimenter l’intérieur de la boucle.
- Variables brand et system dans les prompts (
{{brand.name}},{{system.date}}, etc.) — disponibles partout dans le workflow.
Interdit :
- Relier un node Tool ou AI extérieur à la boucle directement à un node à l’intérieur de la boucle. Le canevas bloque cette connexion et affiche une erreur. Pour une configuration partagée à chaque itération, utilisez un node Static Text ou faites transiter les données via l’entrée List avant le début de la boucle.
Planifiez le flux de données avant de construire la branche interne : tout ce dont la boucle a besoin par élément doit venir de Start loop (l’élément courant) ou d’un node Input / Static autorisé. Tout ce dont vous avez besoin une seule fois pour l’ensemble du lot doit alimenter le port List en amont.
Comment utiliser les données dans la boucle (Start loop)
À chaque itération, Start loop envoie un seul élément de votre liste vers la branche interne — pas le tableau entier.
Étape 1 — Tracer la connexion et nommer votre variable
- Tracez un lien depuis Start loop vers le port d’entrée du premier node interne.
- Lorsque le système vous le demande, donnez à cette variable un nom court et explicite — par exemple
item,ligneoucontact. C’est ce nom que vous référencerez dans les prompts et champs de la branche.
Étape 2 — Référencer la variable avec {{…}}
Dans un prompt ou un champ, les variables s’écrivent entre doubles accolades. Par exemple, {{item}} signifie « insérer ici la valeur de la variable nommée item ».
Étape 3 — Adapter selon le format de votre liste
Votre liste peut contenir des valeurs simples ou des objets avec plusieurs champs.
Liste simple — chaque élément est une valeur brute (par exemple une URL) :
["https://example.com/page-1", "https://example.com/page-2"]Utilisez la variable directement : {{item}} dans le champ Url(s) du Web Scraper.
Liste d’objets — chaque élément possède des champs nommés (par exemple une ligne de contact) :
[
  { "name": "Alice", "email": "alice@example.com", "company": "Acme" },
  { "name": "Bob", "email": "bob@example.com", "company": "Beta" }
]
Utilisez {{item.name}}, {{item.email}}, {{item.company}} pour cibler un champ de la ligne courante.
Lire un champ précis — comment fonctionne le point
Lorsque les éléments de votre liste comportent plusieurs champs, vous en sélectionnez un en ajoutant un point puis le nom du champ après le nom de votre variable.
| Vous écrivez | Ce que cela signifie (en langage courant) |
|---|---|
{{item}} | L’élément courant dans son intégralité |
{{item.email}} | Le champ email de l’élément courant |
{{item.company}} | Le champ company de l’élément courant |
Imaginez une fiche contact : item représente la fiche de la ligne en cours, et .email signifie « prendre la ligne e-mail sur cette fiche ». Le point n’a pas de signification particulière en soi — il sépare simplement le nom de la variable du nom du champ.
Un seul câble depuis Start loop suffit. Si vous avez nommé votre variable item, vous pouvez utiliser {{item.name}} dans le prompt LLM et {{item.email}} dans le champ to de l’Email Sender — les deux lisent la même ligne courante.
Schémas courants dans la branche interne
Schéma 1 — Une variable, plusieurs champs (le plus fréquent)
Câblez Start loop une fois sous le nom item, puis référencez des champs différents dans chaque node :
- Prompt LLM :
Bonjour {{item.name}}, … - Email Sender to :
{{item.email}} - Corps API Connector :
{"company": "{{item.company}}"}
Schéma 2 — Chaîne séquentielle
Seul le premier node a besoin de l’élément de boucle. Les nodes suivants utilisent la sortie du node précédent :
Start loop → Web Scraper ({{item.url}}) → HTML Cleaner → LLM → End Loop
Schéma 3 — JSON Path Extractor
Utile quand les champs sont imbriqués ou que vous souhaitez des sorties nommées explicitement avant d’envoyer les données à des nodes spécialisés :
Start loop → JSON Path Extractor → nodes aval → End Loop
Schéma 4 — Code Block
Quand vous avez besoin de calculs personnalisés ou de plusieurs champs regroupés dans une seule sortie pour End Loop (email, score, summary dans un même objet JSON).
Conditional dans la boucle
Le node Conditional permet de traiter seulement certains éléments ou d’emprunter des chemins différents selon une règle.
Schéma recommandé :
graph LR
    Start[Start loop] --> Cond[Conditional]
    Cond -->|condition vraie| Work[LLM / Web Scraper]
    Work --> End[End Loop]
Cond -->|branche par défaut| End- Branche « vraie » : enchaînez vos nodes de traitement, puis reliez le dernier à End Loop.
- Branche « fausse » / par défaut (ignorer l’élément) : reliez la branche directement à End Loop, sans Stop Node. Un Stop Node dans la boucle arrête tout le workflow, même avec
Skip & Continue. - Convergence : pas besoin d’un node Merge dédié — chaque branche se termine sur End Loop. Seule la branche réellement exécutée produit la sortie collectée pour cette itération.
- Champs absents : si une branche n’est pas exécutée, ses nodes ne produisent pas de sortie. L’itération peut aboutir à une entrée vide ou
nulldans le merged data si aucun terminal valide n’a de résultat.
Plusieurs artefacts par itération (texte, score, métadonnées…)
Le Loop ne regroupe pas automatiquement toutes les variables produites dans la branche. Pour une itération qui doit livrer plusieurs informations :
- Chaîner les nodes jusqu’au dernier, et faire en sorte que ce dernier node produise un seul objet contenant tous les champs (sortie JSON d’un LLM, Code Block avec plusieurs outputs définis, etc.).
- Utiliser un Code Block en terminal : entrée
item+ traitements amont via la chaîne, sorties nommées regroupées dans un objet renvoyé à End Loop. - Ne pas compter sur une agrégation automatique — seule la sortie du node branché sur End Loop entre dans Output (merged data).
Nodes les plus souvent placés juste après Start loop
| Node | Usage typique dans la boucle |
|---|---|
| Web Scraper | Scraper une URL par itération |
| LLM | Personnaliser, analyser ou transformer une ligne |
| API Connector | Appeler une API externe une fois par enregistrement |
| Conditional | Ignorer ou router des éléments selon la valeur d’un champ |
| JSON Path Extractor | Extraire des champs précis de l’élément courant |
| Code Block | Logique personnalisée quand les nodes intégrés ne suffisent pas |
| Image to Text / Image to Image | Traiter un fichier par itération |
En aval dans la branche (pas forcément câblés à Start loop) : HTML Cleaner, Email Sender, Find and Replace, et les nodes d’écriture vers des intégrations.
Comment récupérer la sortie agrégée
Pour exploiter les résultats après toutes les itérations :
- Tracez un lien depuis le port Output (merged data) du node Loop.
- Connectez-le à l’entrée du node suivant (Filter List, JSON Path Extractor, Sheets Writer, etc.).
- Dans ce node suivant, créez et nommez votre propre variable (par exemple,
loop_results). Le tableau agrégé y sera automatiquement injecté.
Exemples d’utilisation
Cas 1 : Scraper une liste d’URL depuis Google Sheets
Vous lisez une liste de lignes URL dans une Google Sheet, scrapez chaque page, puis réécrivez le contenu nettoyé dans une feuille.
graph LR
    A[Google Sheets reader] --> B[Loop Node]
    B -->|Start loop| C[Web Scraper]
    C --> D[HTML Cleaner]
    D --> E[End Loop]
    B -->|Output merged data| F[Sheets writer]
Configuration :
List={{GoogleSheets_0.data}}Max Iterations=100Delay between iterations=2000(2 secondes, scraping respectueux)Error Handling=Skip
Dans la branche de boucle :
- Câblez Start loop vers le Web Scraper et nommez la variable
ligne. - Web Scraper Url(s) =
{{ligne.url}}(chaque ligne de la feuille est un objet avec un champurl).
Cas 2 : Envoyer un e-mail personnalisé à chaque contact
Vous itérez sur une liste de contacts, générez un message personnalisé avec un LLM, puis l’envoyez via le node Email Sender. Un destinataire en échec ne doit pas bloquer le reste.
graph LR
    A[Create List of contacts] --> B[Loop Node]
    B -->|Start loop| C[LLM personalize]
    C --> D[Email Sender]
    D --> E[End Loop]
    B -->|Output merged data| F[Log results]
Configuration :
List={{CreateList_0.list}}Max Iterations=100Delay between iterations=1000Error Handling=Skip
Dans la branche de boucle :
- Câblez Start loop vers le LLM et nommez la variable
contact. - Prompt LLM :
Rédige une courte salutation pour {{contact.name}} chez {{contact.company}}. - Email Sender to :
{{contact.email}}
Problèmes courants
Le workflow échoue avec : Loop node does not have a valid input list
Cause : La valeur connectée à List ne peut pas être parsée comme un tableau JSON. Le node amont a envoyé une chaîne, un objet, ou un payload vide / null.
Solution : Vérifiez que la sortie amont est bien un tableau JSON. Encadrez une valeur manuelle avec ["..."]. Pour Google Sheets, pointez sur le tableau data des lignes. Pour une réponse d’API, ciblez le champ qui contient réellement la liste (par exemple body.results).
Seuls les 100 premiers éléments sont traités
Cause : Max Iterations est plafonné à 100 par le formulaire de paramètres. Toute liste de plus de 100 éléments est tronquée.
Solution : Découpez l’entrée en amont avec le node Split List en lots de 100 éléments maximum, puis chaînez plusieurs Loop. Pour des jeux de données très volumineux, paginez en amont (pagination Sheets, pagination API) et lancez le workflow par lot.
Ma variable reste vide ou inchangée dans la boucle
Cause : Le chemin de champ ne correspond pas à la forme de l’élément courant. Erreurs fréquentes : utiliser {{item.currentItem.email}} (il n’existe pas de couche currentItem — l’élément est directement la ligne courante) ou référencer {{item.url}} alors que la liste contient des URL en texte brut (utilisez {{item}} à la place).
Solution : Inspectez un élément type dans votre entrée List. S’il s’agit d’une chaîne simple, utilisez {{nomDeVotreVariable}}. S’il s’agit d’un objet, utilisez {{nomDeVotreVariable.nomDuChamp}} pour chaque champ nécessaire. Vérifiez que Start loop est bien câblé au node qui utilise la variable.
Je ne peux pas connecter un node extérieur à un node dans la boucle
Cause : Le canevas bloque les connexions directes d’un node Tool ou AI extérieur vers la branche interne. Chaque itération doit rester autonome.
Solution : Faites transiter les données du lot via l’entrée List du Loop avant le début de la boucle. Faites transiter les données par élément via Start loop. Pour des valeurs fixes réutilisées à chaque itération (libellé, extrait de modèle), utilisez un node Static Text ou Static File — ces nodes sont autorisés dans la boucle.
La sortie agrégée contient des null ou moins d'entrées que prévu
Cause : (1) Une branche Conditional a routé l’élément vers End Loop sans traitement — sortie vide. (2) Le node terminal n’a produit aucune sortie exploitable. (3) Des itérations ont échoué avec Error Handling = Skip — elles ne sont pas ajoutées au tableau (il peut être plus court que la liste d’entrée).
Solution : Vérifiez dans l’historique d’exécution quelle branche a tourné. Si vous devez conserver l’entrée ET le résultat, regroupez-les dans un Code Block terminal. Pour ignorer volontairement un élément via Conditional, c’est normal qu’il n’y ait pas de résultat riche — prévoyez un filtre en aval sur Output (merged data) si besoin.
J'ai plusieurs nodes de fin mais une seule sortie dans le merged data
Cause : End Loop ne fusionne pas plusieurs sorties. Le moteur retient une seule sortie de node terminal par itération (la première valide parmi les nodes reliés à End Loop).
Solution : Enchaînez vos nodes en une seule chaîne et ne connectez que le dernier à End Loop. Si vous avez besoin de plusieurs champs, regroupez-les dans la sortie de ce dernier node (objet JSON via Code Block ou LLM).
Erreur de validation : Missing End Loop connection
Cause : Le dernier node de la branche interne n’est pas connecté au point End Loop.
Solution : Tracez un lien depuis le dernier node interne vers End Loop. Tous les nodes entre Start loop et End Loop s’exécutent une fois par élément de la liste.
La boucle est trop lente / met plusieurs minutes pour une petite liste
Cause : Delay between iterations est élevé, ou la branche par itération contient des nodes lents (LLM, scraping).
Solution : Abaissez le délai à son minimum (100 ms) si aucune contrainte de rate limiting externe ne s’applique. Profilez la branche interne et supprimez ou mettez en cache les étapes lentes lorsque c’est possible.
Une itération échoue et arrête tout le workflow
Cause : Error Handling est positionné sur None. La première erreur interrompt la boucle et fait échouer l’exécution.
Solution : Passez Error Handling à Skip & Continue pour que l’exécution survive aux échecs individuels. Ajoutez un node Conditional dans la branche pour ignorer volontairement certains éléments — dirigez la branche par défaut vers End Loop, pas vers un Stop Node.
La sortie agrégée est vide alors que la boucle s'est exécutée
Cause : La branche interne n’a produit aucune sortie, ou toutes les itérations ont été ignorées suite à des erreurs.
Solution : Ouvrez l’historique d’exécution, inspectez chaque itération, confirmez que les nodes internes renvoient bien des données. Basculez temporairement Error Handling sur None pour faire remonter l’erreur sous-jacente.
Bonnes pratiques et pièges à éviter
Nommez votre variable Start loop de façon explicite (contact, ligne, url) avant de remplir les prompts — {{contact.email}} est plus lisible qu’un nom générique lorsque vous revenez sur le workflow des semaines plus tard.
Positionnez Error Handling sur Skip & Continue lorsque Web Scraper ou des nodes API se trouvent dans la boucle. Une URL ou un enregistrement en échec ne doit pas interrompre tout le lot.
N’imbriquez pas des Loops aveuglément. Deux nodes Loop imbriqués multiplient les itérations : 50 catégories × 50 produits = 2 500 itérations, mais chaque Loop est plafonné à 100. Planifiez la limite à chaque niveau et pré-agrégez quand c’est possible pour rester sous le plafond de 100 itérations.
Comment s’intègre-t-il dans un workflow ?
Le node Loop se place entre un node producteur de liste et une branche de traitement par élément, puis ré-agrège les résultats en aval. Schéma typique :
graph LR
    Source[Google Sheets / API / Create List] --> Loop[Loop Node]
    Loop -->|Start loop| Inner[Branche par élément
<br/>scrape / LLM / écriture]
    Inner --> EndLoop[End Loop]
    Loop -->|Output merged data| After[Agrégateur
<br/>Filter / JSON Path / Sheets]
Nodes complémentaires
Logique de branchement à l’intérieur du Loop pour router les éléments selon une condition avant traitement.
Découpez une grande liste en lots de ≤ 100 éléments pour que chaque lot tienne dans le plafond d’itérations du Loop.
Construisez un tableau statique ou dynamique à injecter directement dans l’entrée du Loop.
Filtrez la sortie agrégée du Loop pour ne conserver que les itérations qui satisfont une règle.
Comptez les entrées de la sortie agrégée du Loop pour le reporting ou le branchement.